【Day 27】コンテナを破棄するとデータが消える!? データの永続化の原理 〜書き込み可能レイヤー(OverlayFS)の消滅、ステートレス設計、Volume vs Bind Mount の使い分け、C#ログ・画像保存設計〜
「コンテナを再ビルドしたら、テスト登録したDBレコードや画像が全部消えた…!?」と焦ったことはありませんか?
Windows Server、Hyper-V、VMwareなどで長年インフラや社内システムを構築してきたエンジニアにとって、「仮想マシンのCドライブやDドライブに保存したファイルは、OSを再起動してもマシンを作り直さない限りそのまま残る」というのが当たり前の常識でした。
しかしDockerのコンテナは、「いつでも破棄して作り直せるエフェメラル(使い捨て)なプロセス」として設計されています。そのため、何も設定せずにコンテナ内でデータベースを動かしたり、ユーザーがアップロードしたファイルを保存したりすると、コンテナを破棄(docker rm や docker compose down)した瞬間に、すべてのデータが宇宙の彼方へ消滅してしまいます。
本講義では、なぜコンテナ内のデータが消えるのかという内部アーキテクチャ(OverlayFS / 書き込み可能レイヤー)を解き明かし、データをホストOS側へ安全に逃がして永続化する 「ボリューム(Volume)」と「バインドマウント(Bind Mount)」の原理・使い分け・C#設計パターン を完全マスターします!
INDEX 本日の講義カリキュラム
- 第1章: なぜコンテナを消すとデータが消えるのか? 〜OverlayFSと書き込み可能レイヤーの構造〜
- 第2章: コンテナの「ステートレス(無状態)原則」とデータの寿命管理
- 第3章: 永続化の2大手法「ボリューム(Volume)」vs「バインドマウント(Bind Mount)」徹底比較
- 第4章: ホスト退避アーキテクチャの動作メカニズム
- 第5章: C#/.NET現場におけるデータ保存設計(ログ・アップロードファイル・DB)
- 第6章: 本日のまとめと次回予告(Day 28: SQL Serverボリューム実践)
第1章: なぜコンテナを消すとデータが消えるのか? 〜OverlayFSと書き込み可能レイヤーの構造〜
従来の仮想マシン(VMwareやHyper-V)では、ゲストOSのディスク全体が1つの仮想ハードディスクファイル(.vhdx や .vmdk)としてホスト上に実体を持っています。そのため、VMの電源を切っても、ゲストOS内で作成したファイルはディスク上に永久に保存されます。
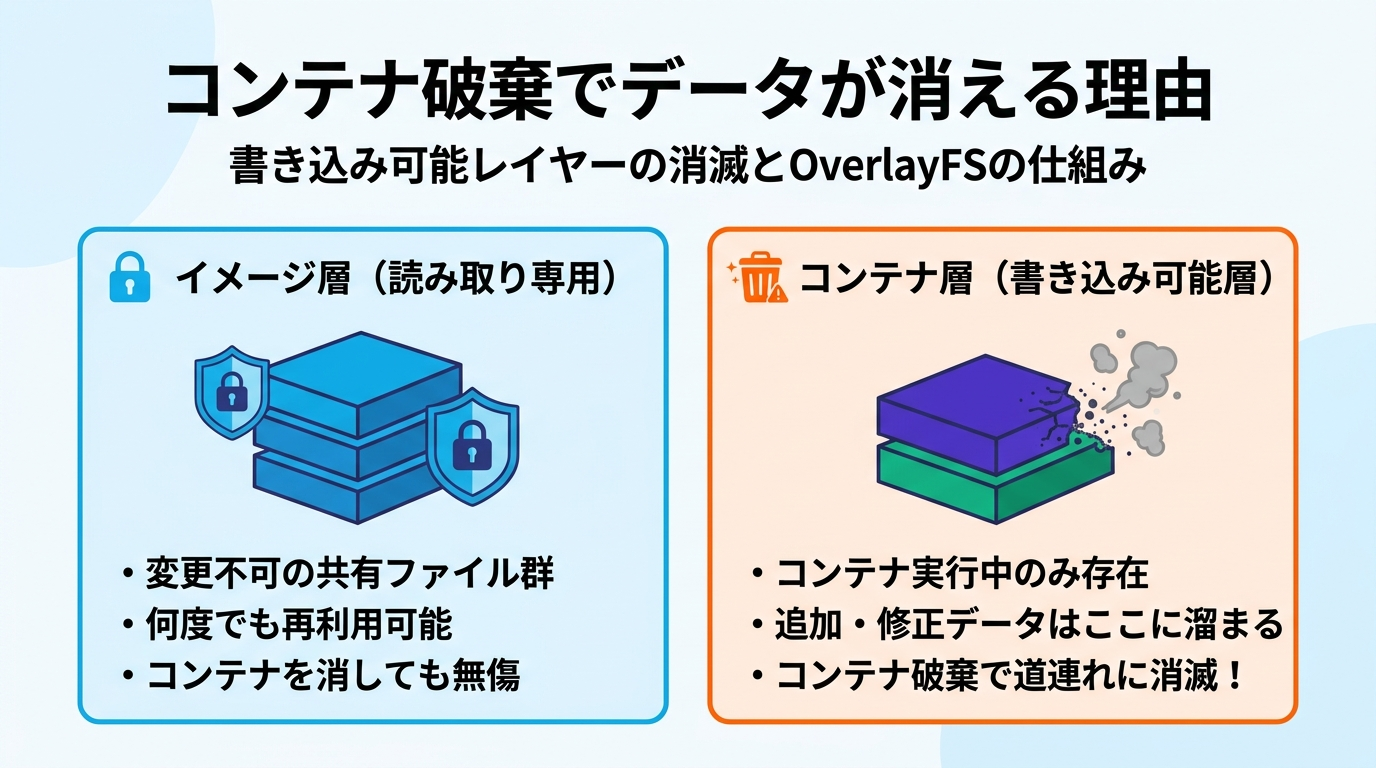
これに対し、Dockerコンテナのファイルシステムは 「多層構造(UnionFS / OverlayFS)」 という特殊な仕組みで動いています。
- イメージ層(Image Layers: Read-Only):
Dockerfileでビルドされた各命令(FROM,COPY,RUN等)の成果物。完全に読み取り専用(イミュータブル)であり、複数のコンテナ間で共有されます。 - コンテナ層(Container Layer: Read-Write): コンテナが起動した瞬間に、イメージ層の最上位に被せられる 極薄の書き込み可能レイヤー。コンテナ内で新しく作成されたファイルや変更されたファイルは、すべてこのレイヤーにのみ記録されます。
ここが最大のポイントです。コンテナを停止(docker stop)しただけであれば、コンテナ層はまだ保持されているためデータは消えません。しかし、コンテナを破棄(docker rm や docker compose down)した瞬間、このコンテナ層はコンテナプロセスと一緒に綺麗さっぱり消滅 します。
下層のイメージ層は無傷ですが、コンテナ層に書かれていた「アプリケーションが書き込んだログ」「登録したDBレコード」「ユーザーがアップロードした画像」は、跡形もなく消え去ってしまうのです。
第2章: コンテナの「ステートレス(無状態)原則」とデータの寿命管理
「それなら、コンテナを破棄してもコンテナ層を自動保存してくれれば便利なのでは?」と思うかもしれません。しかし、これこそが クラウドネイティブ・コンテナ設計の大原則「ステートレス(無状態)設計」 です。
⚠️ なぜコンテナ内に状態(データ)を持ってはいけないのか?
- いつでも使い捨てて水平スケーリングするため: アクセス増に伴いコンテナを1個から10個へスケールアウトするとき、各コンテナがローカルにデータを持っているとデータ不整合が発生します。
- ゼロダウンタイムでバージョンアップするため: アプリの新バージョンをデプロイする際、「旧コンテナを破棄して新コンテナを起動する」というローリングアップデートを行います。コンテナ内にデータがあると、デプロイのたびにデータが失われてしまいます。
- 障害時の自動復旧(自己修復)のため: コンテナがハングアップした場合、KubernetesやDocker Composeはコンテナを殺して即座に別ノードで新しいコンテナを立ち上げます。
したがって、コンテナアーキテクチャでは 「コンテナ自体はいつでも死んで良いエフェメラルな存在とし、保持すべきデータはコンテナの外(ホストOSやクラウドストレージ)に逃がす」 のが絶対の鉄則となります。
第3章: 永続化の2大手法「ボリューム(Volume)」vs「バインドマウント(Bind Mount)」徹底比較
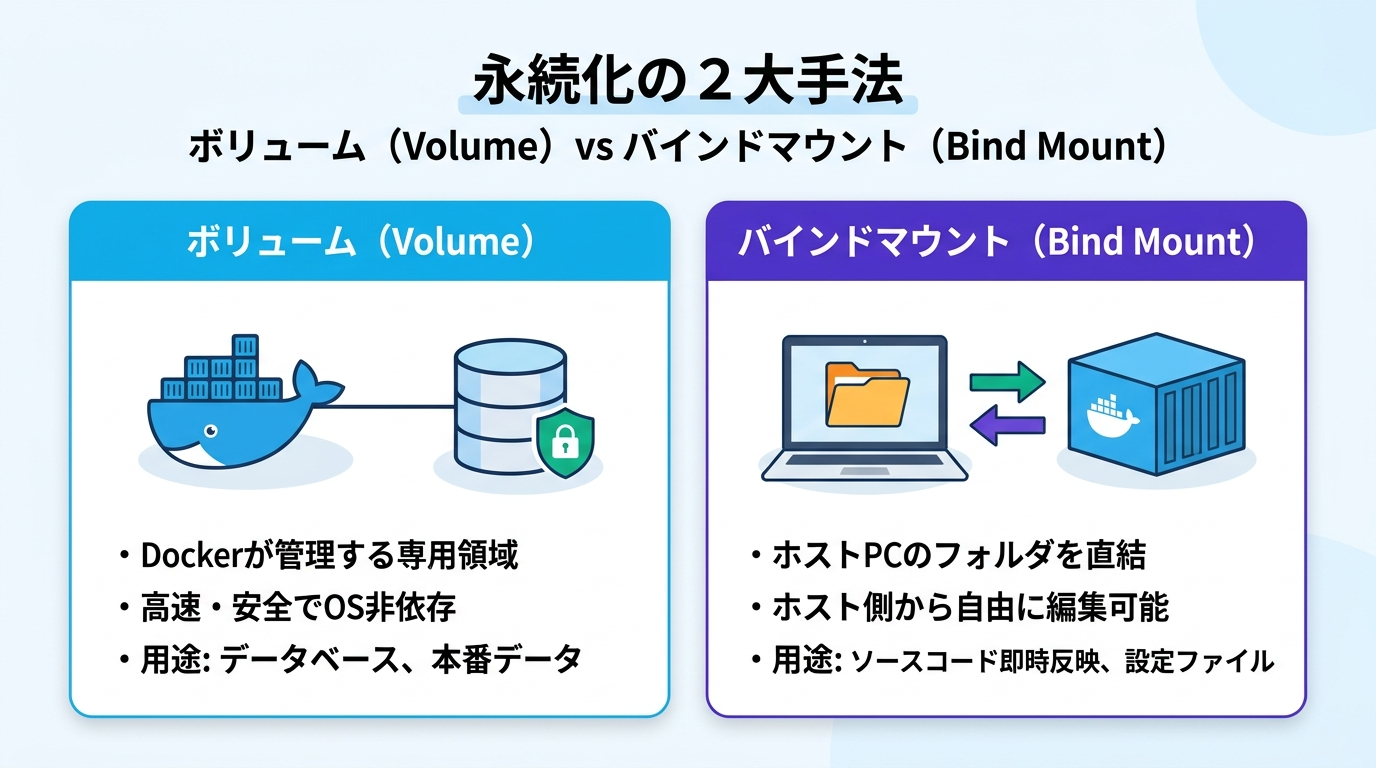
データをコンテナ外部へ逃がして永続化するための手法として、Dockerには 「ボリューム(Volume)」 と 「バインドマウント(Bind Mount)」 という2大マウント方式が用意されています。
ボリューム(Volume)
Docker自身が管理する専用ストレージ領域(Linuxホスト上の /var/lib/docker/volumes/ 配下)。
- ホストのファイル構造を意識不要(Docker CLIで管理)
- I/Oパフォーマンスが極めて高く安定
- パーミッション問題が起きにくい
- 推奨用途: データベース(SQL Server, PostgreSQL, MySQL)、永続化ストレージ
バインドマウント(Bind Mount)
ホストPCの特定ディレクトリをコンテナ内に直結 する方式(./src:/app/src 等)。
- ホスト側でファイルを編集すると即座にコンテナ内に反映
- コンテナ側が生成したファイルをホストから直接閲覧可能
- OS間(Windows/Linux)のパーミッションや改行コードに注意
- 推奨用途: ローカル開発時のソースコード同期(ホットリロード)、設定ファイル注入
| 比較項目 | ボリューム(Volume) | バインドマウント(Bind Mount) |
|---|---|---|
| 保存場所 | Docker管理下の領域(ホストユーザーから直接触らない) | ホストPC上の任意のディレクトリ(開発者が直接編集) |
| 移植性(ポータビリティ) | ◎ 非常に高い(Windows/Mac/Linux問わず同一設定で動作) | △ ホストのディレクトリ構造に依存(相対パス推奨) |
| I/O速度(WSL2上) | ◎ ネイティブLinux速度(超高速) | ○ WSL2領域なら高速(Windows側Cドライブ直結は遅延あり) |
| 主なユースケース | DBデータ永続化、ログ集約、本番データ保管 | ローカル開発でのコード編集・ホットリロード(dotnet watch) |
第4章: ホスト退避アーキテクチャの動作メカニズム
「コンテナを破棄してもデータが消えない」というのは、具体的に内部でどのような動きをしているのでしょうか?
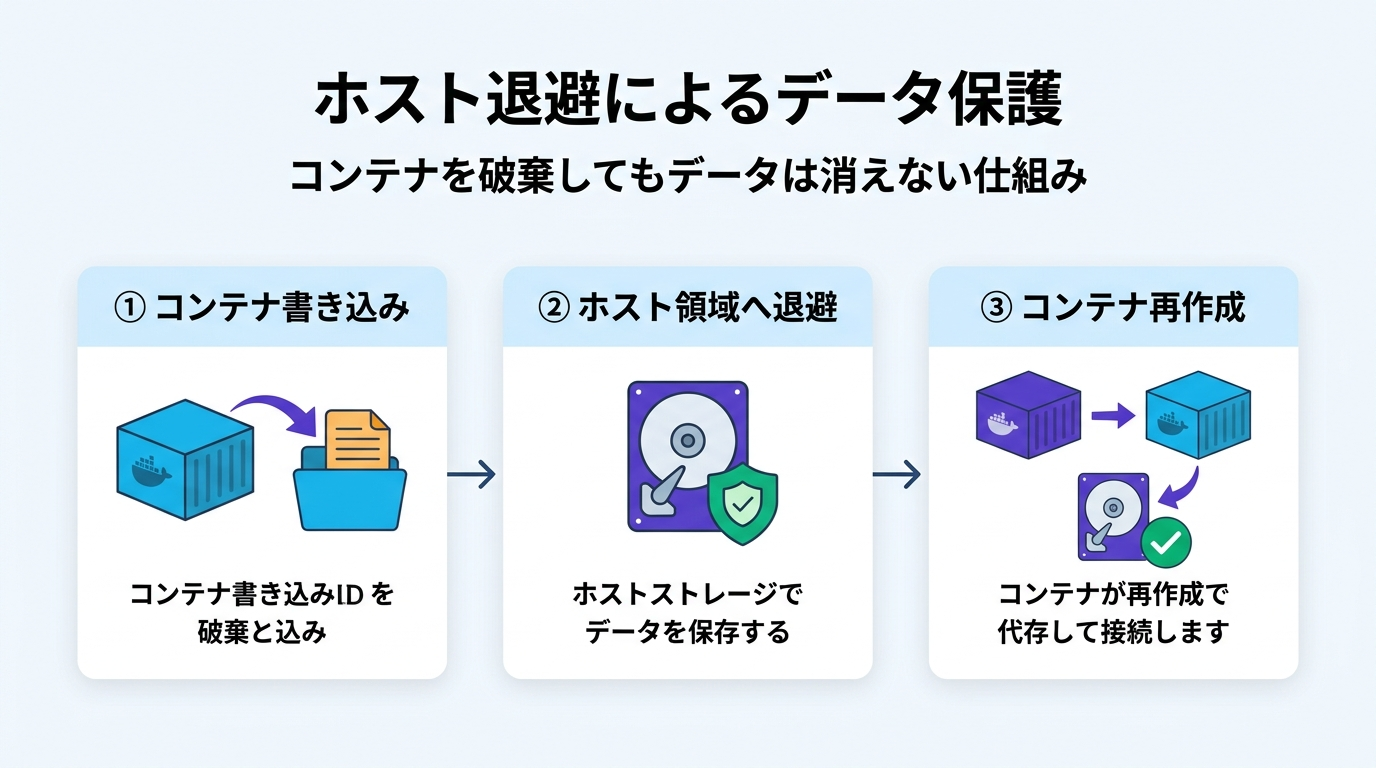
その秘密は、「コンテナ内の特定ディレクトリへのアクセスを、OverlayFSの書き込み可能レイヤーを通さずに、ホスト側のストレージへバイパス(直結)する」 というマウント機構にあります。
🔄 ホスト退避によるデータ保護の3ステップ
/app/data や /var/opt/mssql/data にファイルを書き込みます。
docker compose down で古いコンテナを削除し、最新イメージで docker compose up して新コンテナを立ち上げても、同じボリュームを指定すれば、前回のデータにそのまま再接続されます!
第5章: C#/.NET現場におけるデータ保存設計(ログ・アップロードファイル・DB)
それでは、C#/.NETの開発現場において、どのようなデータをどこに保存すべきか、実践的なアーキテクチャ設計を見ていきましょう。
① 実例: Serilogによるログ出力設計(STDOUT vs ボリューム)
.NET Framework時代のIIS開発では、C:\inetpub\logs\log.txt などのローカルファイルにログを出力するのが一般的でした。
しかしコンテナの世界におけるベストプラクティス(The Twelve-Factor App原則)は 「ログはファイルに書かず、すべて標準出力(Console / STDOUT)に流す」 です。
using Serilog;

var builder = WebApplication.CreateBuilder(args);

// コンテナベストプラクティス: ログは標準出力(Console)へ流す
builder.Host.UseSerilog((ctx, lc) => lc
    .WriteTo.Console()
    // コンプライアンス等でファイル保存が必須な場合のみ、ボリュームマウントされたパスを指定
    .WriteTo.File("/app/logs/application-.log", rollingInterval: RollingInterval.Day));

var app = builder.Build();
app.MapGet("/", () => "Hello Docker Persistence!");
app.Run();
標準出力に流されたログは、Dockerのログドライバーによって自動的に管理され、docker compose logs -f やクラウド(AWS CloudWatch, Azure Log Analytics等)へシームレスに集約されます。もしファイル出力が必要な場合は、/app/logs をボリュームにマウントします。
② 実例: ユーザーがアップロードした画像の永続化
ECサイトや社内システムで、ユーザーがWeb画面からアップロードした商品画像やPDFファイルを wwwroot/uploads に保存するケースです。
このディレクトリをコンテナ内に置いたままにすると、デプロイのたびにユーザー画像が全滅します!以下のように docker-compose.yml で名前付きボリューム(Named Volume)を定義して救出します。
services:
  web-api:
    build:
      context: .
      dockerfile: Dockerfile
    ports:
      - "5000:8080"
    volumes:
      # アップロード画像フォルダを名前付きボリュームにマウント!
      - app-uploads:/app/wwwroot/uploads
      # ログ出力先も永続化
      - app-logs:/app/logs

# 最下部でボリュームを明示的に宣言
volumes:
  app-uploads:
    driver: local
  app-logs:
    driver: local
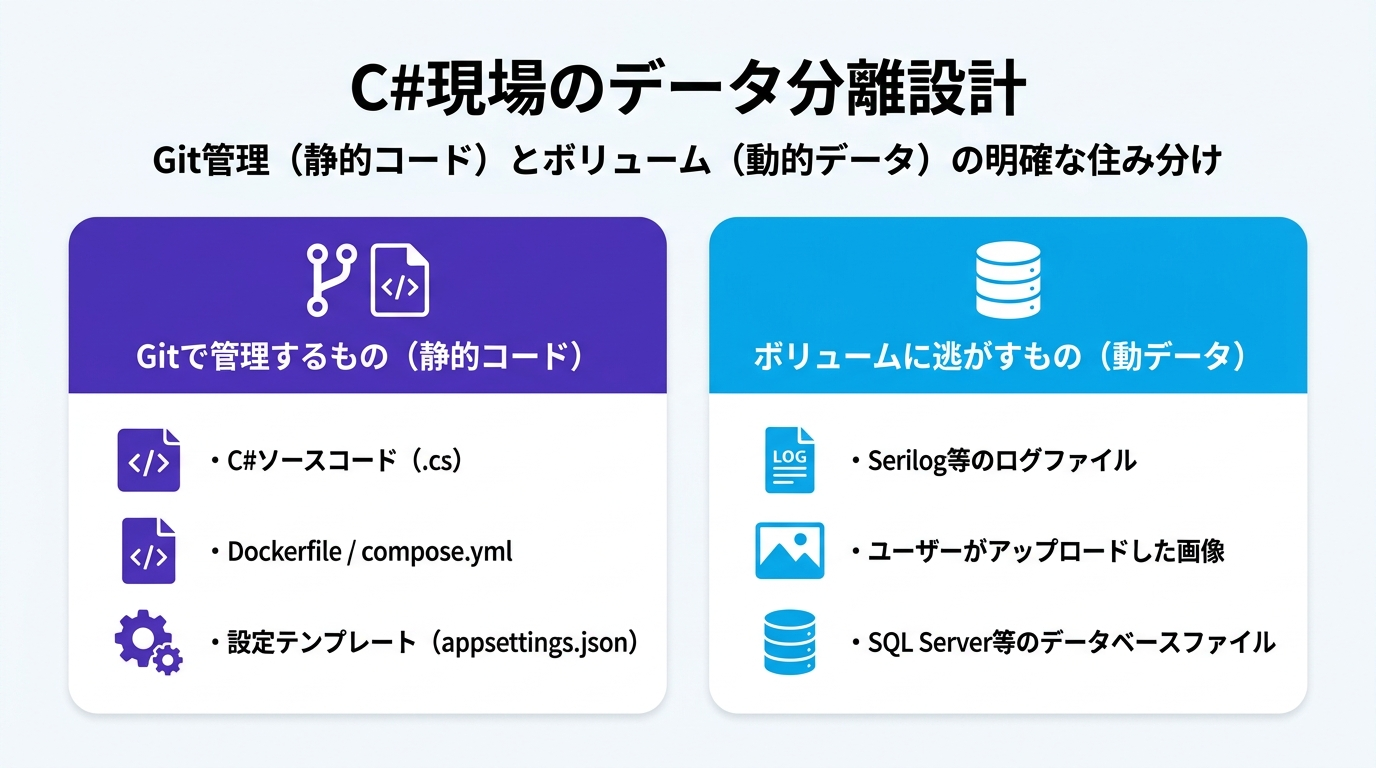
③ Git管理(静的コード)とボリューム(動的データ)の明確な住み分け
チーム開発で最もやってはいけない重大な事故が、「データベースのファイルやログ、アップロード画像などの巨大バイナリをGitにコミットしてしまうこと」 です。
現場での明確な住み分けルールを以下のマトリクスにまとめました。
| 対象データ | 管理場所 | 理由・運用ルール |
|---|---|---|
| C#ソースコード(.cs, .csproj) | Git(リポジトリ) | アプリケーションの設計図。差分管理とPRレビューの対象。 |
| Dockerfile / docker-compose.yml | Git(リポジトリ) | インフラのコード化(IaC)。チーム全員で同一環境を再現。 |
| 環境設定テンプレート(.env.example) | Git(リポジトリ) | キー名のみをGit管理(機密値が入った実.envは除外)。 |
| SQL Server DB実ファイル(.mdf / .ldf) | ボリューム(Volume) | 絶対にGitへコミット禁止(リポジトリ破壊の元)。Volumeで安全保持。 |
| ユーザーアップロード画像・PDF | ボリューム(Volume) | 動的に増減するバイナリデータ。.gitignore で確実に除外。 |
第6章: 本日のまとめと次回予告
📌 本日の重要ポイントまとめ
- コンテナのファイルシステムは2層構造: 読み取り専用の「イメージ層」の上に、使い捨ての「コンテナ層(書き込み可能)」が乗っている。
- コンテナ破棄で書き込み層は消滅:
docker rmやcompose downを行うとコンテナ層ごと消えるため、内部のデータは消失する。 - ステートレス設計の大原則: コンテナ自体は「いつでも破棄・再生成できる無状態」を保ち、保持すべきデータはホスト側に逃がす。
- 永続化の2大巨頭:
- ボリューム(Volume): Docker管理領域。高速・安全でDBや本番データの永続化に最適。
- バインドマウント(Bind Mount): ホストフォルダ直結。ローカル開発時のソースコード同期(ホットリロード)に最適。
- GitとVolumeの厳格な分離: コードやDockerfileはGitで管理し、DBデータやログ、アップロード画像はVolumeに逃がして
.gitignoreで徹底除外する。
次回 【Day 28】ボリューム(Named Volume)によるSQL Serverデータの安全な永続化
原理を理解したところで、次回はいよいよ実務での実践編!
SQL Serverコンテナのデータディレクトリ(/var/opt/mssql/data)をNamed Volumeにマウントし、コンテナを破棄・再ビルドしてもテストデータが1件も失われない堅牢なDB開発環境を構築します。お楽しみに!
コメント
コメントを投稿